
Te ajutăm cu lucrarea în inteligență artificială
Privat. Primul capitol gratuit. Fără avans. Plata la final sau în etape. Status constant al lucrării. Raport AI + plagiat.
Scrie-ne pe WhatsAppCuprins · 7 secțiuni
La licență în inteligență artificială antrenezi și evaluezi un model pe o problemă concretă, de obicei într-o aplicație care îl folosește; la disertație compari abordări pentru a răspunde la o întrebare de cercetare. Mai jos ai ce tip de lucrare alegi, ce se schimbă de la licență la disertație, cum descrii modelul în capitole, 14 teme și ce întreabă comisia. Bibliotecile de bază (pandas, scikit-learn, Flask) sunt pe pagina despre lucrarea în Python.
La licență, comisia vrea un model evaluat corect: datele împărțite înainte de antrenare, o referință simplă cu care îl compari, metrici potrivite problemei și o analiză a greșelilor. La disertație adaugi o întrebare legată de articole recente, experimente repetate și o discuție despre limite, inclusiv despre date și părtinire.
Ce poți face în inteligență artificială la licență
| Tipul lucrării | Tehnologii | Exemplu de temă |
|---|---|---|
| Învățare automată pe date tabelare | scikit-learn, XGBoost | Estimarea valorii apartamentelor din anunțuri |
| Viziune artificială | rețele convoluționale în PyTorch sau TensorFlow, OpenCV | Detectarea defectelor pe piese, din fotografii |
| Prelucrarea limbajului natural | modele transformer preantrenate (Hugging Face), spaCy | Sentimentul din recenziile de produse în română |
| Aplicații cu modele mari de limbaj | un LLM prin API sau un model deschis, căutare semantică, RAG | Asistent care răspunde din documentele unei firme, cu sursa citată |
Pe date tabelare (vânzări, credite, analize medicale), modelele clasice, cum sunt arborii de decizie și gradient boosting, dau de multe ori rezultate bune și se explică mai ușor. Rețelele neuronale se justifică mai ales la imagini, text și sunet. La o aplicație cu LLM nu antrenezi modelul: partea ta e cum îi dai informația potrivită și cum măsori dacă răspunde corect.
La licență și la disertație
Aceeași tehnologie, alt nivel. Apasă pe unul ca să vezi ce se așteaptă și un exemplu de cod.
LLa licență
un model evaluat corect, într-o aplicație care merge
Comisia vrea să vadă tot drumul: datele și sursa lor, cum le-ai împărțit, modelul ales față de o referință simplă, metricile și ce greșește modelul. Dacă tema o cere, modelul rulează într-o aplicație, de exemplu un API sau o pagină în care încarci o imagine.
- Setul de test îl pui deoparte de la început și îl folosești o singură dată, la final.
- Orice model îl compari cu o referință simplă, de exemplu clasa cea mai frecventă.
- Hiperparametrii îi alegi pe setul de validare, nu pe cel de test.
Exemplu: recunoașterea cifrelor scrise de mână din setul de date inclus în scikit-learn, cu o rețea neuronală mică. Am rulat scriptul cu Python 3.
from collections import Counter

from sklearn.datasets import load_digits
from sklearn.dummy import DummyClassifier
from sklearn.model_selection import train_test_split
from sklearn.neural_network import MLPClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_digits(return_X_y=True)  # 1.797 imagini de 8x8 pixeli, cifrele 0-9
# 60% antrenare, 20% validare, 20% test; testul il folosesti o singura data, la final
X_ant, X_rest, y_ant, y_rest = train_test_split(X, y, test_size=0.4, stratify=y, random_state=0)
X_val, X_test, y_val, y_test = train_test_split(X_rest, y_rest, test_size=0.5, stratify=y_rest, random_state=0)

referinta = DummyClassifier(strategy="most_frequent").fit(X_ant, y_ant)  # raspunde mereu cu aceeasi cifra
print(f"Referinta: {referinta.score(X_val, y_val):.3f} pe validare")

retele = {}
for n in (16, 64, 128):
    retele[n] = make_pipeline(StandardScaler(), MLPClassifier(hidden_layer_sizes=(n,), max_iter=1000, random_state=0)).fit(X_ant, y_ant)
    print(f"Retea cu {n} neuroni: {retele[n].score(X_val, y_val):.3f} pe validare")

ales = max(retele, key=lambda n: retele[n].score(X_val, y_val))  # alegi doar dupa validare
print(f"Ales: {ales} neuroni, {retele[ales].score(X_test, y_test):.3f} pe test")
prezise = retele[ales].predict(X_test)
erori = Counter((int(a), int(p)) for a, p in zip(y_test, prezise) if a != p)
print("Cele mai dese confuzii (reala, prezisa):", erori.most_common(3), "din", sum(erori.values()), "erori")Referința are acuratețea 0,100 pe validare: ghicește o cifră din zece. Rețelele cu 16, 64 și 128 de neuroni: 0,967, 0,972 și 0,969. Aleasă e cea cu 64, care obține 0,961 pe test: 14 greșeli din 360 de imagini, cea mai frecventă fiind un 3 citit ca 5, de două ori. Cele trei rețele sunt foarte apropiate, așa că alegerea dintre ele contează puțin.
Comisia caută: de ce scorul pe test e puțin sub cel de pe validare (rețeaua a fost aleasă după validare, deci acel scor e ușor optimist) și ce ai face cu cifrele confundate.
DLa disertație
o întrebare de cercetare, experimente repetate
La master pornești de la o întrebare precisă, legată de articole recente. De exemplu: cât ajută regularizarea unei rețele neuronale când ai puține date etichetate? Răspunsul îl dă o curbă de învățare: scorul pe antrenare și pe validare, pe măsură ce crește setul de antrenare.
- Validare încrucișată cu aceleași împărțiri pentru toate variantele și semințe aleatoare fixate.
- Media și abaterea standard pe fold-uri, nu un singur scor.
- La LLM și RAG: un set de întrebări cu răspunsuri verificate și metrici stabilite înainte de experiment.
- Datele descrise complet: sursa, licența, cum au fost etichetate, ce grupuri lipsesc.
import numpy as np
from sklearn.datasets import load_digits
from sklearn.model_selection import StratifiedKFold, learning_curve
from sklearn.neural_network import MLPClassifier
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

X, y = load_digits(return_X_y=True)
validare = StratifiedKFold(n_splits=5, shuffle=True, random_state=0)

# aceeasi retea, cu regularizare slaba si puternica (parametrul alpha)
for alpha in (0.0001, 1.0):
    retea = make_pipeline(StandardScaler(), MLPClassifier(hidden_layer_sizes=(64,), alpha=alpha, max_iter=1000, random_state=0))
    marimi, ant, val = learning_curve(retea, X, y, cv=validare, train_sizes=[0.1, 0.25, 0.5, 1.0])
    print(f"alpha = {alpha}")
    for n, a, v in zip(marimi, ant, val):
print(f" {n:4d} exemple: antrenare {a.mean():.3f}, validare {v.mean():.3f} (+/- {v.std():.3f}), diferenta {a.mean() - v.mean():.3f}")Cu 143 de exemple, rețeaua învață perfect setul de antrenare (1,000), dar nimerește doar 0,778 pe validare; cu 1.437 de exemple ajunge la 0,972. Diferența dintre antrenare și validare scade de la 0,222 la 0,028: cu puține date, rețeaua învață pe de rost. Regularizarea mai puternică (alpha = 1) ajută pe seturi mici (0,801 față de 0,778), dar pe setul întreg diferența (0,973 față de 0,972) e mai mică decât abaterea dintre fold-uri, deci nu poți spune că o variantă e mai bună.
Comisia caută: ce îți spune forma curbei (mai multe date ar ajuta?) și cum ai verificat că o diferență nu e întâmplătoare. Vezi și ce este lucrarea de disertație.
Cum descrii modelul în lucrare
Capitolele în care apare modelul. Apasă pe unul ca să-l deschizi.
1Studiul literaturii
cu cine te compari
 Așa arată în exemplul nostru →
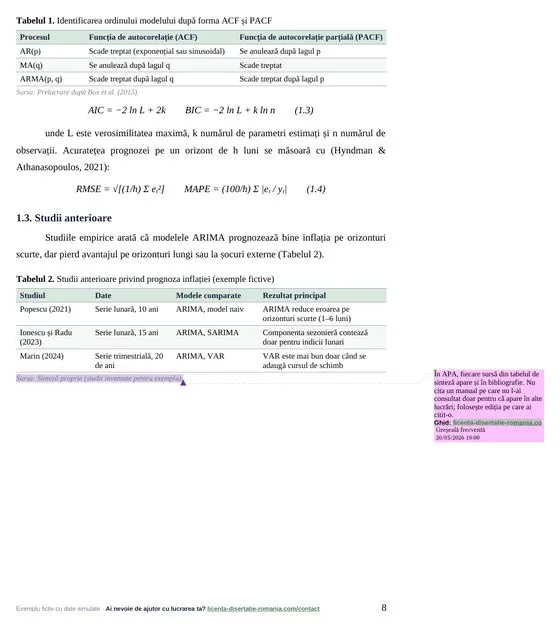
Ce s-a mai încercat pe problema ta, într-un tabel: articolul, setul de date, metoda, metrica și rezultatul. Din tabel reiese ce lipsește și ce aduce lucrarea ta. La disertație, articolele sunt recente, din conferințe și reviste de specialitate.
2Datele
sursa, curățarea, împărțirea
 Așa arată în exemplul nostru →
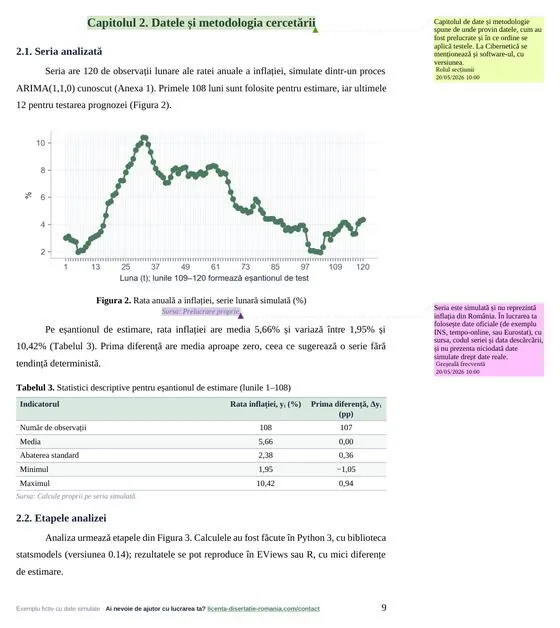
De unde vin datele, câte exemple și clase ai, cum le-ai curățat și etichetat, cum le-ai împărțit în antrenare, validare și test. Spune cum ai evitat scurgerea de informație: aceeași persoană nu apare și la antrenare, și la test, iar normalizarea se calculează doar pe datele de antrenare.
Comisia caută: că știi exact pe ce date ai lucrat și că testul a rămas neatins.
3Modelul și antrenarea
arhitectura, hiperparametrii, mediul de lucru
 Așa arată în exemplul nostru →
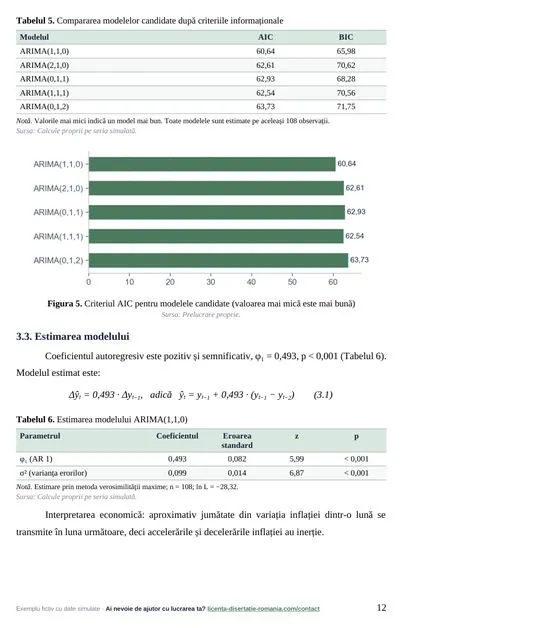
Algoritmul sau arhitectura rețelei, hiperparametrii și cum i-ai ales, bibliotecile cu versiunile lor, pe ce ai antrenat (procesor sau placă video) și cât a durat. O figură cu eroarea pe antrenare și pe validare, de-a lungul antrenării, arată dacă modelul a început să învețe pe de rost.
4Evaluarea
metrici, comparații, analiza greșelilor
 Așa arată în exemplul nostru →
Metricile potrivite problemei, comparația cu referința și cu alte modele, matricea de confuzie și exemple concrete de greșeli, cu o explicație pentru fiecare tip. La disertație: medii, abateri standard și un test statistic înainte de concluzie.
5Limite și etică
unde poate greși modelul și pe cine afectează
Pe ce date nu ai testat, unde modelul poate greși sistematic (de exemplu, pe un grup slab reprezentat în date), ce date personale folosești și cu ce acord. Limitele spuse de tine arată că îți înțelegi modelul; cele descoperite de comisie arată contrariul.
Teme de licență și disertație în inteligență artificială
LTeme de licență
8 teme
- Sentimentul din recenziile de produse scrise în română, cu un model transformer preantrenat.
- Detectarea defectelor pe piese dintr-o linie de producție, din fotografii.
- Recunoașterea plantelor din fotografii, într-o aplicație mobilă.
- Estimarea valorii apartamentelor din anunțuri imobiliare (gradient boosting).
- Recomandări de cărți sau filme după notele utilizatorilor (filtrare colaborativă).
- Asistent pentru întrebările clienților unei firme, cu RAG peste documentele ei.
- Detectarea e-mailurilor de phishing din textul și linkurile lor.
- Numărarea persoanelor dintr-o încăpere, din imagini video (detecție de obiecte).
DTeme de disertație
6 teme
- Sisteme RAG pe documente în română: cum influențează împărțirea textului corectitudinea răspunsurilor.
- Învățare cu puține date etichetate: augmentare, transfer de învățare și învățare semi-supravegheată.
- Părtinirea modelelor de acordare a creditelor între grupuri de clienți și metode de corectare.
- Modele mici pe telefon față de modele mari în cloud: acuratețe, viteză și consum.
- Robustețea clasificatoarelor de imagini la zgomot și la atacuri adversariale.
- Halucinațiile modelelor de limbaj: cum le măsori și cât le reduce verificarea surselor.
Mai multe idei, pe niveluri de dificultate: teme de licență la Informatică.
Ce întreabă comisia
- Cum ai împărțit datele și cum te-ai asigurat că testul nu a influențat antrenarea?
- De ce metrica aleasă și nu doar acuratețea?
- Cu ce referință ai comparat modelul?
- Ce greșește modelul și de ce crezi că greșește acolo?
- Cum ai evitat supraînvățarea? (regularizare, mai multe date, oprire timpurie)
- Ar funcționa modelul pe date dintr-o altă sursă sau pe alt grup de oameni?
Răspunsurile le pregătești odată cu prezentarea și discursul de susținere.
Lucrarea în inteligență artificială la comandă
- Modelul și aplicația, pe tema ta: pregătirea datelor, antrenarea, evaluarea și, dacă e nevoie, aplicația care folosește modelul, cu codul comentat.
- Lucrarea scrisă: literatura, datele, metoda, experimentele și limitele, cu citări în stilul cerut.
- Prezentarea PowerPoint, discursul de susținere și întrebările probabile ale comisiei.
- Corectare și tehnoredactare, dacă ai deja lucrarea.
Raportul de similaritate și verificarea de text generat cu AI sunt incluse. Livrăm în maxim 2 zile, iar plata se face după livrare, fără avans. Scrie-ne pe WhatsApp tema și ghidul facultății și primești primul capitol gratuit.
Întrebări frecvente
Trebuie să antrenez modelul de la zero sau pot folosi unul preantrenat?
Poți porni de la un model preantrenat și să-l adaptezi pe datele tale, o practică obișnuită la imagini și text. Contribuția ta e adaptarea, datele, evaluarea și aplicația, iar în lucrare spui clar ce ai preluat și ce ai făcut tu.
Pot face licența cu o aplicație bazată pe un model mare de limbaj?
Da, dacă partea ta e clară: cum îi dai modelului informația potrivită, de exemplu prin RAG, cum verifici răspunsurile și cum măsori calitatea pe un set de întrebări cu răspunsuri cunoscute. O aplicație care doar trimite întrebarea mai departe riscă să pară prea simplă.
De unde iau datele pentru o lucrare de inteligență artificială?
Din seturi publice, de pe platforme precum Kaggle sau Hugging Face, din datele unei firme, cu acordul ei, sau colectate de tine. Verifică licența setului și, dacă sunt date personale, cum au fost obținute. Sursa o descrii complet în capitolul despre date.
Am nevoie de o placă video puternică?
Nu neapărat. Modelele clasice și rețelele mici se antrenează pe un laptop obișnuit; pentru rețele mari poți folosi servicii în cloud cu plăci video, unele cu un acces gratuit limitat. În lucrare notezi pe ce ai antrenat și cât a durat.
Ce metrici folosesc pentru evaluare?
Depinde de problemă. La clasificare, acuratețea doar dacă clasele sunt echilibrate, altfel precizia, recall-ul și F1; la regresie, eroarea medie absolută sau pătratică; la detecția de obiecte, mAP. Metrica o alegi înainte de experimente, nu după rezultate.
Ce are în plus o disertație în inteligență artificială?
O întrebare de cercetare legată de articole recente, experimente repetate cu aceleași împărțiri și semințe fixate, comparații cu metodele din literatură și o discuție despre limitele modelului. Codul și configurațiile le pui pe un repository, ca experimentele să poată fi refăcute.